“消失”的万亿债务:深扒数据中心“影子借贷”、GPU金融化与次贷风险
《硅谷101》从五大 hyperscaler 回购骤降与资本开支飙升切入,拆解 Meta 的 Hyperion SPV、微软融资租赁、谷歌付款担保、亚马逊与 Oracle 长期租约,说明万亿级 AI 基建义务如何被移出传统债务口径。节目继续追踪 GPU 抵押贷款、ABS、SRT 与私募信贷的资金链,并用真实云收入、抵押品残值和银行体系杠杆检验 AI 次贷危机类比的边界。
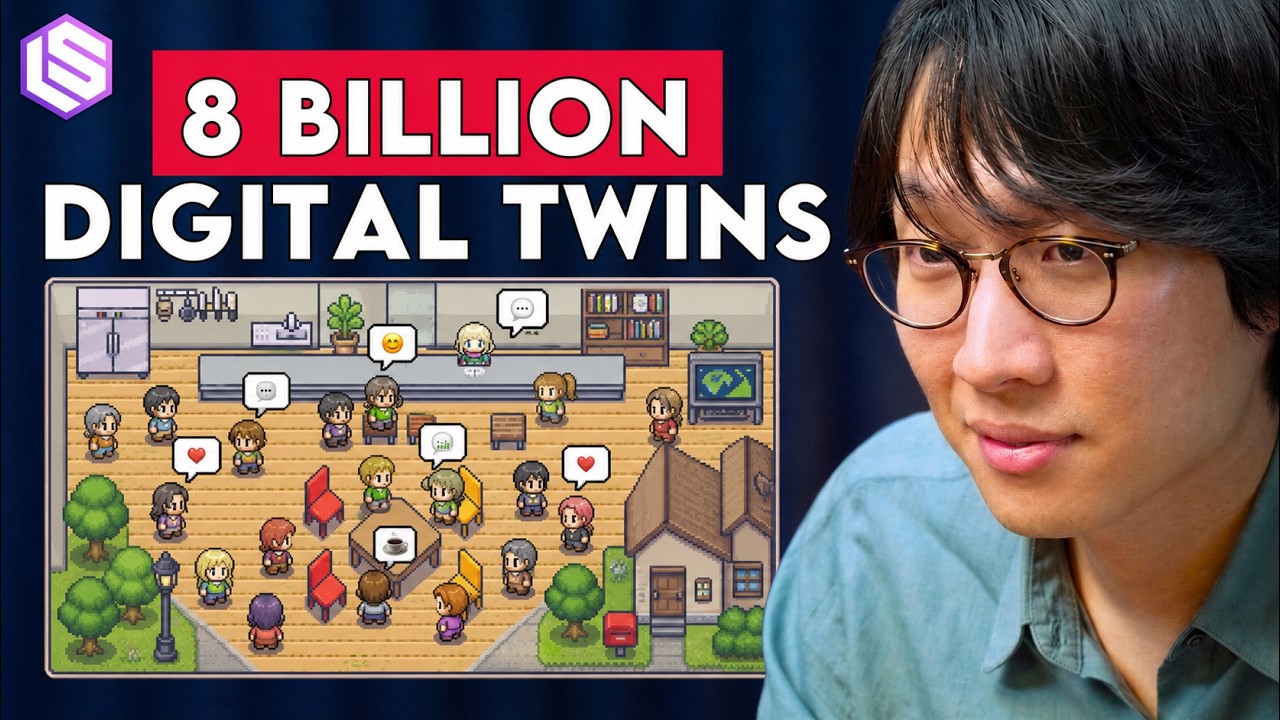
Joon Sung Park 从 Smallville 的 generative agents 出发,解释 Simile 如何用深度访谈、观察行为与随机对照试验建立可验证的数字孪生。 对谈从 1,000 人研究的 85% 相对准确度,推进到多 agent 社会、80 亿人模拟,以及用反事实路径改善现实决策的长期愿景。
17岁的苏庭灏独立学习预训练、反复做小模型实验,并以注意力机制论文进入 ICML 2026 Main Track。这期对谈也记录了一个 AI 原住民更深的困惑:当机器可能做得更好,学习、职业与人生意义如何重新成立。
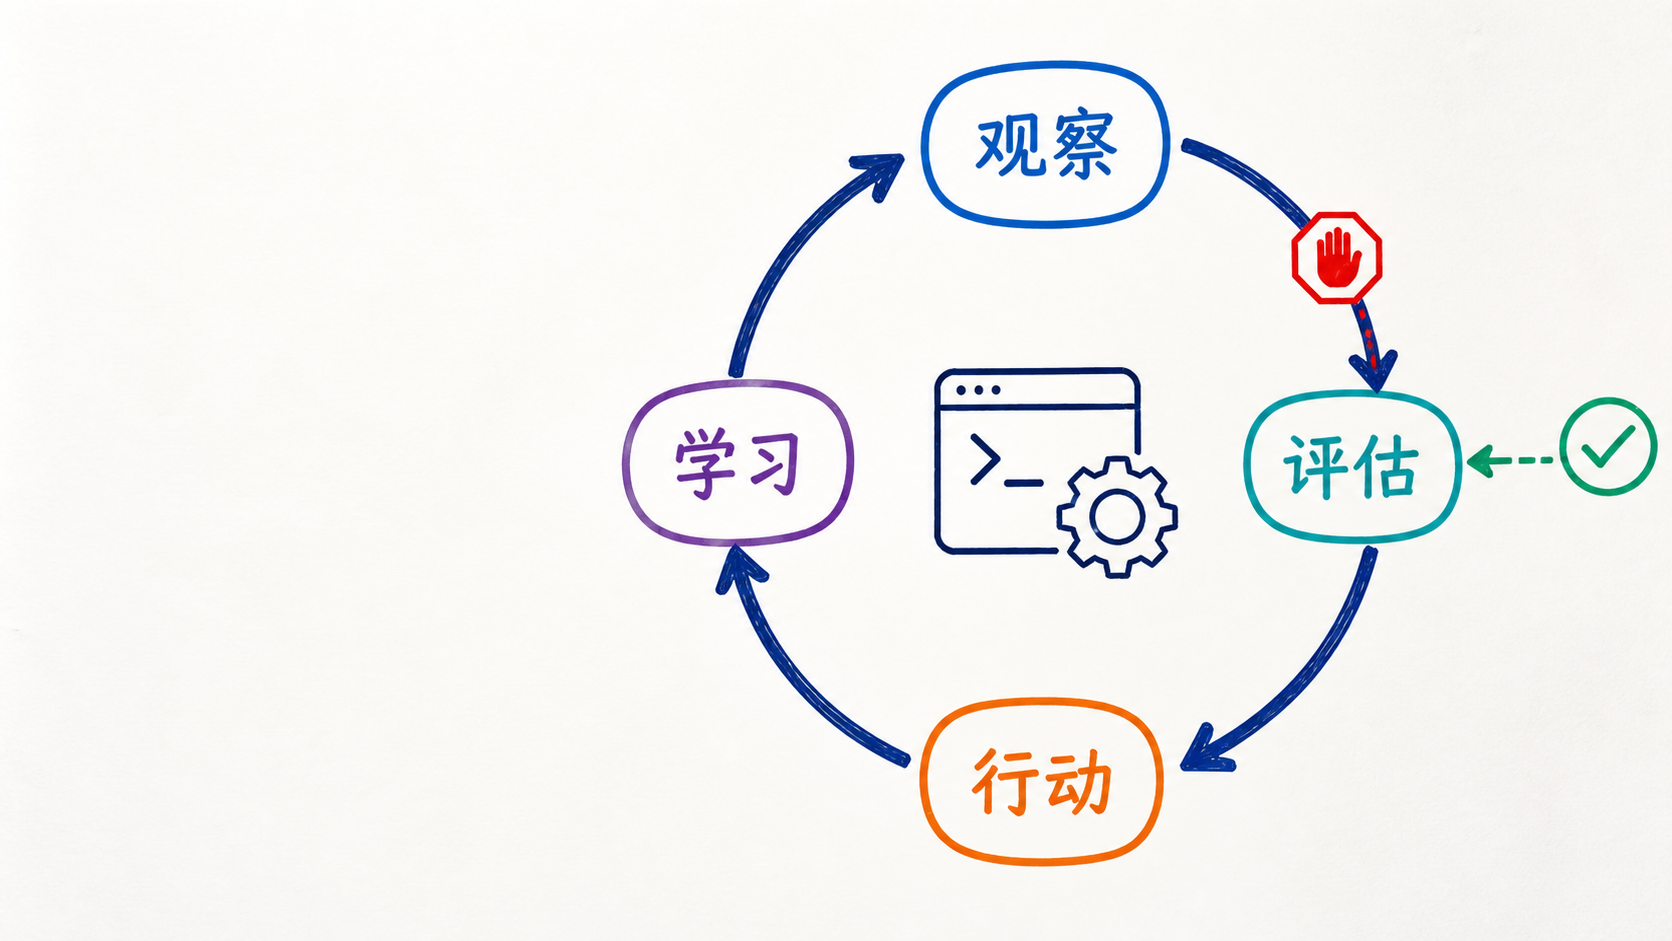
这场 MLOps.community 读书会把 loop engineering 从流行词拆成可运行的工程结构: 观察、评估、验证、修复、停止条件与持久化学习。Arthur 分享生产 harness 的返工与信任问题, Val 展示双层 coding-agent loop,圆桌进一步讨论 token 成本、并发边界和内置 goal/loop 命令。
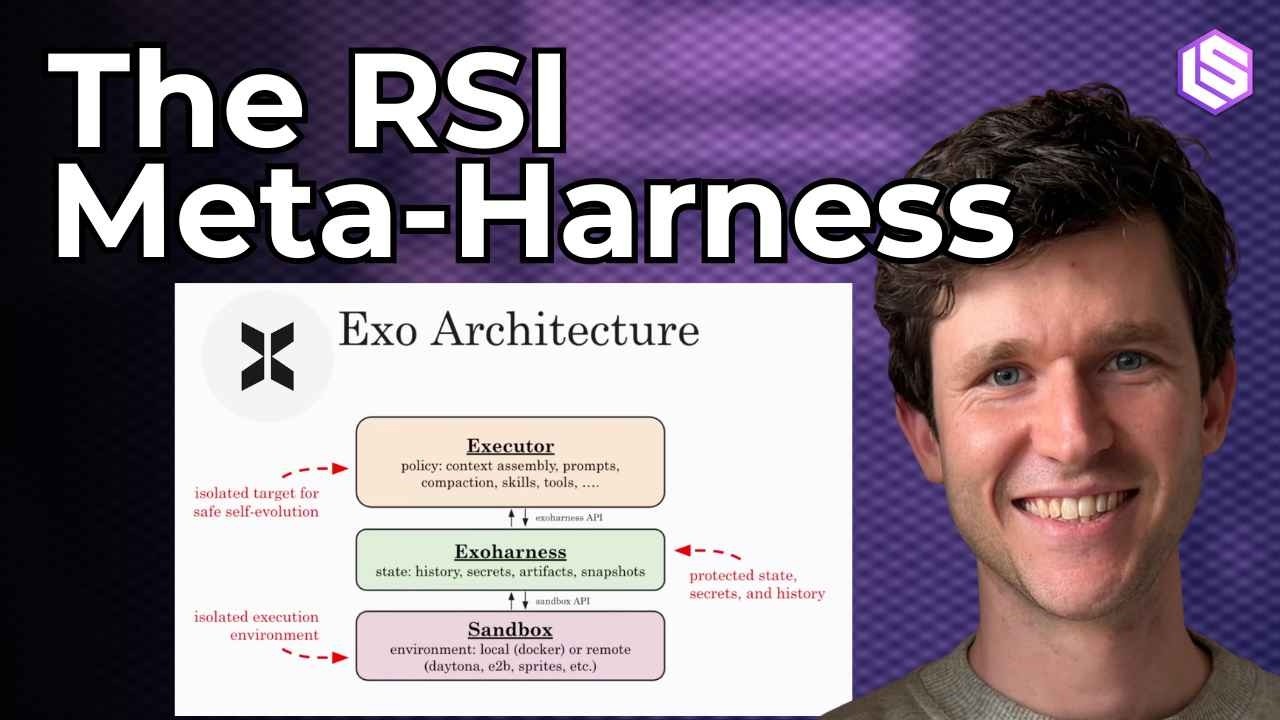
Alex Krentsel 解释 Exo 如何把 agent 拆成无状态 executive、受保护 harness 与隔离 sandbox,使 policy 可以在运行时查看并修改自己的代码。对谈进一步讨论自动回滚、秘密隔离、可迁移执行、可中断任务,以及自我优化为何必须受到 eval 约束。
曹原从数学、代码与 Agent 工作流成熟的背景出发,拆解 AI for Science 如何通过提出假设、执行实验、验证结果和反馈更新形成科研闭环。对谈继续追问验证瓶颈、概念抽象、神经符号路线、数学与物理的差异,以及当证明供给过剩后人类仍需承担的定义、理解和价值判断。
NVIDIA 研究副总裁刘洺堉回顾从传统计算机视觉、GAN 与 diffusion 走到 Cosmos 3 的二十年研究路径,并解释为什么 Physical AI 需要一个把语言、视频、音频与动作统一起来的 world foundation model。对谈也深入到模型之外:如何从 22 个模型收敛为一个、如何让 200–300 人同时对齐与自主决策,以及 Jensen Huang 的长期主义怎样影响研究与组织选择。
张小珺对英伟达研究副总裁、Cosmos Lab 负责人刘洺堉的长访谈。内容从他二十年的生成模型研究路径出发,深入 Cosmos 3 的统一世界基础模型、Physical AI 的泛化难题,以及英伟达如何用开放模型、组织机制和长期投入共同创造新市场。
Ryan Greenblatt 与 Dwarkesh Patel 拆解 AI 自动化 AI 研发后的反馈回路:为什么研究可能加速、能力如何向工业世界迁移,以及奖励黑客为何可能随模型变强而更难发现。对谈同时追问模型究竟应当对齐用户、公司还是社会,并讨论透明度、监督与治理能否在竞争压力下跟上。
Matt McPartlon 与 Neil Patil 解释 Chai 如何从结构预测走向抗体生成,并用 50 个 target、约 20% 平均 binding hit rate 与 0.33 Å 结构误差验证模型的真实进展。对谈进一步拆解专业分子设计产品、湿实验反馈、算力与持久执行基础设施,以及药物发现为何正在从瀑布式试错转向精密工程闭环。
Fields Medalist Jacob Tsimerman 解释数学为何可能成为最早被 AI 深度改写的知识工作之一:瓶颈将从找到证明,转向理解、归类与选择方向。 对谈进一步讨论形式化证明与共同理解的差别、理论构建是否真是稳定的人类角色,以及他为何暂别学界转向 OpenAI 的 AI safety 工作。 给年轻人的结论不是放弃数学,而是继续追随热爱,同时尽早接触 AI、理解新工作节奏并为职业路径保留弹性。
Fei-Fei Li 从视觉演化、ImageNet 与现代 AI 的三元汇合讲起,解释模型为何强大,也说明未被记录的人类体验为何仍构成边界。 对谈进一步讨论医疗、教育、机器人与空间智能,主张以人的能动性、尊严和多方参与来决定 AI 如何进入社会。
这期从百度团队早期的 Scaling Law 发现出发,追踪 Cerebras 为什么用整片晶圆重新设计 AI 计算,并如何用微小核心、冗余和动态路由解决良率难题。故事进一步解释国家实验室、G42 与高速推理如何把一项超前技术推向规模商业化,以及 IPO 后供应链、竞争和毛利率带来的现实约束。
Philip Kiely 与 Ali Taha 从一条 200,000-token 请求出发,拆解 cache-aware routing、 prefill/decode 解耦、投机解码、量化、并行和跨节点 KV cache 搬运。对谈进一步讨论 视频推理的注意力瓶颈,以及训练、推理与模型自优化逐渐形成反馈闭环的可能路径。
刘子鸣从物理学、KAN 与机制可解释性出发,解释了一条非主流的 AI for AI 路线:先结构化研究过程,再用 AI 自动化 Physics of AI。对谈同时拆解了中美 Neo Lab 的兴起、原模型预测训练曲线的技术设想,以及从 Training Copilot 走向 Vibe Training 的产品终局。
游凯超复盘自己从算法研究转向机器学习系统的路径,以及 vLLM 如何从 PagedAttention 论文原型成长为生产级开源推理引擎。对谈进一步拆解中国开源模型浪潮、社区治理与公司化、Coding Agent 对贡献机制的冲击,以及模型、推理系统和硬件 co-design 的效率逻辑。
Akshay Nathan 解释 OpenAI 如何把 Codex 的 agent harness 扩展到 ChatGPT Work,并用共享能力、差异化 UX、artifacts、插件与持久上下文构建面向知识工作的统一入口。访谈也深入讨论了 Sites、subagents、Memory V3、Chronicle,以及 AI 时代团队为什么必须从产出代理指标转向高质量学习闭环。
游凯超回顾自己从算法研究转向机器学习系统、加入 vLLM 核心维护团队,并把校园开源项目推进为 Inferact 的过程。 对谈进一步拆解 PagedAttention、开源治理、模型与基础设施协同设计,以及 coding agent 时代社区和推理 workload 的变化。
Jay Hack 从 Codegen 的创业与并购经历出发,解释为什么代码领域的编译、单测与性能反馈让 Agent 最先形成可验证闭环, 又为什么会写和执行代码的 Agent 能按需创造工具,最终与通用知识工作 Agent 收敛。 对谈进一步讨论上下文与软件整合、生成式界面、科研迁移、世界模型、可解释性,以及知识删除和现实执行带来的安全边界。
Xaira 的 Bo Wang 与 Ci Chu 解释了为什么能预测细胞干预的因果模型,必须由大规模因果数据驱动。对谈从 Perturb-seq 数据工程、X-Cell 的扩散架构与生物先验,一直讲到跨细胞情境泛化、评测、开放科学和下一代测量瓶颈。
这期节目追溯 SK 海力士从韩国财阀现金流、海力士债务危机到押中 HBM 的完整路径,并拆解内存墙、TSV 与 MR-MUF 等关键技术。节目也把离婚案引出的政治资本争议与存储周期风险放回同一张产业地图中,解释技术领先为何仍离不开制造、认证、治理与扩产。
Lila Sciences 把 RL with Verifiable Rewards 从数学和代码推进到真实实验:模型提出问题、调用实验室工具,由自然测量返回奖励与训练数据。Andy Beam 与 Rafa Gómez-Bombarelli 解释柔性实验室、跨域科学 reasoning model、10T 级验证轨迹,以及量子点、CAR-T、材料发现和未来 data-center lab 的现实边界。
Kay Ke 从传统机器人、机器学习与强化学习的交汇处,拆解 Physical Intelligence 的 π₀、π₀.₅ 与 π*₀.₆ 三条研究主线。对谈进一步讨论真实机数据、评测、本体形态、中国硬件供应链,以及机器人自我组装所打开的长期想象。
柯丽一鸣从信息学竞赛、传统机器人实验室与筷子机器人讲起,梳理规划控制和机器学习两条族谱如何汇流成今天的通用机器人大脑。对谈重点拆解 PI 从 π₀ 的能力、π₀.₅ 的泛化到 π*₀.₆ 的性能主线,并延伸到真机数据、强化学习、人形路线、中美硬件产业链与机器人自我组装的长期想象。
Denny Lee 以台湾抹茶研究为入口,解释 Agent 辩论、会话分叉与共享执行如何改变个人和团队的工作流。 对谈进一步拆解 Omnigent 的 meta-harness 思路:让模型与 harness 可替换,同时统一管理上下文、策略、预算、协作、评估与持久状态。
长上下文能容纳更多文本,却无法自动带来稳定的整体推理。Dan Biderman 解释 Engram 如何用 cartridge、参数化记忆与 context management 组合,让企业和个人模型从经验中持续学习,同时保留可审计的文本知识与健康遗忘。
Danielle Perszyk 从认知科学出发,解释为什么 Agent 的可靠性不能只看点击与任务完成, 而要看它是否能持续建模用户的目标、偏好与变化中的意图。对谈进一步讨论集体智能、 社会世界模型、多 Agent 累积文化、人类能动性,以及能够保护认知摩擦的 AI tutor。
Akshat Bubna 从 workload shape 出发,解释 Modal 为什么把弹性推理、post-training、batch 与 agent sandboxes 建在一套自配置 runtime 上。对谈深入 speculative decoding、GPU snapshot、17 家云供应商之上的可靠性层、私有网络与 RDMA,并讨论 DX 转向 AX 后的可观测性、产品反馈和硬安全边界。
Shahram Anver 以 Cleric 的演化为线索,解释为什么更强的模型需要更坚固的 sandbox,而生产级 AI SRE 的耐久壁垒正在从调查 loop 下沉到环境、验证与学习。对谈进一步讨论人类如何转向例外审批与品味判断,以及 coding、SRE、security agents 如何形成有治理的协作团队。
Eiso Kant 复盘了从早期 code models 失败到 Poolside 模型工厂的路径,并解释为何开放权重还不够,开放研究才真正降低新模型公司的进入门槛。对谈还深入讨论了小模型的持久行为、agent 反哺研究、极简 harness、RL 的日历时间瓶颈,以及开放模型的治理边界。
Tommy Wood 从突触连接与修剪出发,解释新奇挑战、clutch 状态、练习节奏和注意力如何共同扩展学习能力。对谈进一步区分有氧、间歇和抗阻训练对脑结构的作用,并讨论营养缺口、痴呆风险与脑震荡恢复的证据边界。
沈宇军从视觉生成研究讲到蚂蚁灵波的具身原生路线:为什么机器人大脑需要从物理世界需求出发,重做视觉预训练、实时架构与跨本体数据管线。对谈也给出当前能力的边界——位置随机性已有进步,但机器人的 GPT-1 时刻仍取决于可规模化、可被模型使用的数据。
Dianne Penn 复盘 Anthropic 如何让研究、模型与产品共同演进:从 Golden Gate Claude 和 Opus 3 的 coding 押注,到 Claude Code 与更强模型互相解锁。她也解释了为什么 evals 正在成为研究型 PM 的核心产物,以及在生成越来越便宜后,判断、验证和亲手 shipping 为什么更加重要。
Vincent Koc 复盘 OpenClaw 从全球热潮走向稳定基础设施的过程:团队如何在高速 Agent 开发中犯错,又如何用测试工厂、AI review 与权限边界把可靠性补回来。对谈也深入讨论中国的快速采用、个人 Agent 与 coding agent 的差异、模型和 harness 的共同作用、记忆难题,以及基金会为何坚持做跨模型生态的中立层。
Evan Feinberg 与 Sergey Edunov 解释了为什么 3D 药物结构预测正在成为扩散模型最活跃的研究前沿之一。 对谈从 PEARL 的合成数据、物理先验、推理时 scaling 与 1 Å 精度门槛,延伸到 ADMET、多目标优化、实验反馈和 SAPPHIRE agent。 核心判断是:可靠的底层结构与性质模型先跨过实用阈值,自动化药物发现才会放大正价值。
Andrew Ambrosino 从 Codex app 团队的内部实践出发,解释当实现成本骤降后,产品工作的瓶颈为何转向品味、筛选、媒介选择和跨团队一致性。对谈也给出了 Codex 与 ChatGPT 合流的产品逻辑:一个面向开发者起步的 agent 工作面,正在通过浏览器、连接器、自动任务和专业软件扩展成知识工作的 home base。
Ethan He 在 xAI 从 0 infra / 0 data / 0 model 起步,3 个月内带几个工程师交付了 Grok Imagine 0.9(首个大规模部署的 audio-video joint generation 模型)。这期访谈把 视频模型的全链路拆开讲: synthetic text-video pair、VAE tokenizer、temporal vs frame-by-frame 压缩、step distillation、长视频的 context 管理。他给 world model 下了一个 三支柱定义 (real time + interactive + long horizon),并提出一个"big claim" —— 现在视觉模型的进步主要来自语言模型,而不是视频模型本身——这也是他刚离开 xAI 想回到 语言模型 / context-aware agent 方向的原因。
Rocket Ride 两位联合创始人讨论 "coding 不再是瓶颈" 之后的新工作 —— intentionality / tool discovery / quality 才是新岗位;为什么 Claude 在增量工程上偷懒、容易写出 "spaghetti code that's not worth shipping"; Rocket Ride 怎么把 AI 应用拆成 node + 五条 lane,让 Claude 用一句英文拼出 45 节点的 pipeline; 以及一个 12+9 小时的 Crew AI 同步噩梦 (dog/cat/elephant) 如何揭出 "plumbing 才是大坑";最后讨论 $25k AWS 账单背后的 cost observability 和 model server 聚合 (一张 "big-ass GPU" 服务 100 个客户)。
Radical AI 的 CEO Joseph Krause 解释为什么材料科学不是 AI for bio—— 没有 SMILES/SELFIES 那样的字符串能描述一块合金,所以模型再大也 one-shot 不出 能装进 iPhone 或飞上 Starship 的新材料。解药是 self-driving lab:让 AI scientist 自己跑研究 campaign。Radical 三个月做了 1,200 块合金,对比 DARPA × GE Aerospace 的 MACH 项目一年 500 块。Joseph 的反共识结论:材料行业不缺算力,缺实验; 在科学里,experiments are the moat, models are not.
硅谷101 机器人特辑第一期。结论很反直觉:在机器人世界里,开可乐比走路难十倍——控制灵巧手要比控制躯体难上至少十倍。从 Unitree G1($16k 整机)到 Shadow Robot($100k+ 一只手)的价格落差出发,节目走访了 TetherIA(特斯拉前灵巧手负责人的创业团队),梳理了灵巧手 40 年技术演进、"性能/成本/可靠性"不可能三角、六大门派路线对比(直驱 / 绳驱 / 液压 / 连杆 / 混合 / 开源),并实测了抓 5mm 螺丝钉、大盒子、可乐瓶、桌面 iPhone 四个 demo。TetherIA Aero Hand Open 用 $300 开源策略试图复刻"Android 之于手机"对垄断市场的颠覆。
硅谷101 陈茜对话多位机器人本体业内人士,把人形机器人拆成骨架、关节、传感器、电气计算四大系统逐一讲透。 从空翻时几十个 g 的冲击、减速器的"不可能三角"、电机能效 3% 与 5% 的鸿沟, 到前特斯拉 AI 硬件负责人复盘 Optimus 单芯片改双芯片的反复,再到供应链从"求着别人"到"滚雪球"的转折。
Ronak Malde 从 Windsurf 一路被 DeepMind 收购,然后掏出收购款回来做 Trajectory.ai—— 一个押注 continual learning 是下一代 AI 产品形态的平台。访谈里他拆了 SDPO 这个自蒸馏 RL 算法、Continuous LoRA 的并发训练栈、以及和 Harvey + Nemotron 3 训出来的法律模型。
田渊栋在 Meta 10 月 600 人 AI 裁员风波中被裁,被裁前已有 offer。在这场访谈里,他坦诚谈了对 LLM 路线、Scaling Law、RL 与 SFT、AI 人才市场的判断,回顾了在 FAIR 十年最大的收获——research taste,并谈到他想成为"超级研究员"的下一步设想。
田渊栋离开 Meta FAIR 半年后,与 Richard Socher、熊蔡明、Tim Rocktäschel 等 7 位顶级研究员一起创立 Recursive Superintelligence(RSI),6.5 亿美元融资、46.5 亿美元估值。 这一期他第一次系统讲述了 RSI 的技术路线:用 AI 优化 AI(左脚踩右脚),把 auto research 作为商业化第一步,以及他认为现在 AI 能力大约在"满分 10 分的 0.5 分"。 对话还覆盖了 NeoLab 全景、coding 之后的下一波、大厂蒸馏员工的"吸星大法"、以及"水越来越少,鱼必须变成四维生物"的就业大趋势。
Dust 联合创始人讨论"单人 AI → 多人 AI"的产品边界:为什么 Claude Code / Codex 仍然本质上是单人模式(任务时长仍是半天,模型能力是 jagged 的), 以及他们的回答 —— Pod:一个把多代理、多人类、GCS-FUSE 共享文件系统封装在一起的工作单元。还讨论了 Stripe 早期的 flocking 算法机制、fog of AI 下的对齐难题、 tokconomics 的终局(commoditization)与过渡期(需求挤压维持高价)、为什么 flat pricing 死了、以及 stateful sandbox + SQLite 作为 SaaS 的可能替代。
Databricks 联合创始人 Matei Zaharia 和 Reynold Xin 在 Latent Space 拆解 Data+AI Summit 的三大发布:开源的 Agent Cloud(Omnigent)、Postgres-on-Lake 的 Lakebase(LTAP)、 以及从零重写的分析引擎 Dream Engine。沿着「为什么开源、为什么不统一引擎只统一存储、 为什么 ML 模型选算法比工程师写算法更好」三条主线展开,背后是「过度拟合一两个客户、 让工程师直接写原型不要走文档流程」的工程文化。
硅谷101 飞到上海智元机器人数采工厂,亲手试了一把"遥操作采集员",并和觅蜂、Sharpa 等机器人公司聊清楚了一件事:机器人没有 LLM 那种"吃掉互联网"的福利 —— 每一条高质量数据都必须从零生产。 这一期把四层数据金字塔(遥操 / 仿真 / 动捕 / 视频)的优势、上限、代价讲透了,并给出了一个非常具体的"黄金配方" —— 遥操在数据池里大约只占万分之一,但决定模型能不能落地。
Mark Chen 在 Latent Space "cooking series" 一边煮韩式豆腐汤一边讲清楚 OpenAI 的研究路线: scaling laws 在 10 个数量级上没有破,pre-training is dead 是循环出现的伪叙事,evals 行业整体在"裸奔", reasoning(o1)能上线靠的是 Jakub 和 Ilya 的 conviction 而不是显然的算法红利, 3 年路线图的终点是 end-to-end research——模型不仅做实现,还能有 taste。
Latent Space 把 Cognition 的 Walden Yan 和 OpenInspect 作者 Cole Murray 拉到一起聊"背景 agent"这一架构的成熟。 Devin 自己 repo 上的 commit 占比 3 个月内从 16% 涨到 80%,merged PR 涨 7×,工程团队只涨 10%。 这场对谈把背景 agent 落地需要解决的所有硬件、网络、testing、memory、Slack 集成等具体工程问题摊开。
三位来自不同位置的从业者——MIA 的应用研究者 Frederique、Bell Canada 的企业 AI 负责人 Shao、加拿大主权 GPU 云 Buzz HPC 的 Allan——围绕一场心理健康 AI 黑客松展开圆桌:从平台该提供什么、Codex/Claude Code/Cursor 这些"Pokemon 名字"工具其实可以替换底层模型,到从 API key 蜜月期走向自托管开源模型的 tokenomics 觉醒;从 GPU 硬件通胀(Michael Burry 错了,A100 七年仍涨价)到 Blackwell vs Ampere 的 VRAM 取舍;从 80% → 95% 的死亡幽谷、LLM-as-judge 的踢皮球,到 RL gyms、verifiable rewards、Lean 攻陷 Erdős;最后落到 constrained generation 为什么是闭源 API 永远不开的杀器、为什么 Deep Research 能远超 Claude Code、以及"agent 给 Jira 付了 10,000 次款"背后的治理真问题。
Ahmad Awais 解释为什么 DeepSeek V4 在编码 agent 里"很慢、很笨"——不是模型不够强, 而是它发出错的 tool call 后听不进 Zod error,平均会原样重发 56 次。 他们写了 3,200 行确定性 repair logic(现在 16,000 条 variation,覆盖 600 亿 tokens), 让 DeepSeek/Kimi/MiniMax 在 Command Code 里跑出接近 Opus 的体验,并把同一思路推广到 设计 slop 和安全代码。第二条产品线 Taste 自动学习你的微决策、存成 git 里的 markdown, 让便宜模型借用贵模型沉淀下来的判断力。
张小珺·语言即世界 EP.140,对姚顺宇的 4 小时访谈节选。姚顺宇博士毕业于斯坦福 理论高能物理,2024 年半道出家加入 Anthropic 参与 Claude 3.7、4.5 的强化学习训练; 2025 年 10 月跳槽到 Google DeepMind 做 Gemini 的 ML coding / long horizon。 这期把两家 lab 的打法、coding bet 的内部信号、AI safety 的"幼稚"自我说服、 以及"个人英雄主义时代已经过去了"等小疯言论摊开讲清楚。
硅谷101 用瑞利判据 CD = K₁·λ/NA 为骨架,把 EUV 光源、蔡司透镜、High-NA / Hyper-NA、计算光刻 OPC / ILT、芯片命名"骗局"、纳米压印、以及 ASML 与美国政府的政治经济史串成一条主线。 访谈了 SPIE Fellow 庞博士(ILT 曲线掩膜贡献者)、ASML 前机械工程师 Evan Tao、ASML 传记作者 Marc Hijink。核心判断:光刻机硬件未来 10-25 年不会大变,真正的突破来自 GPU 加持的 AI 算法。
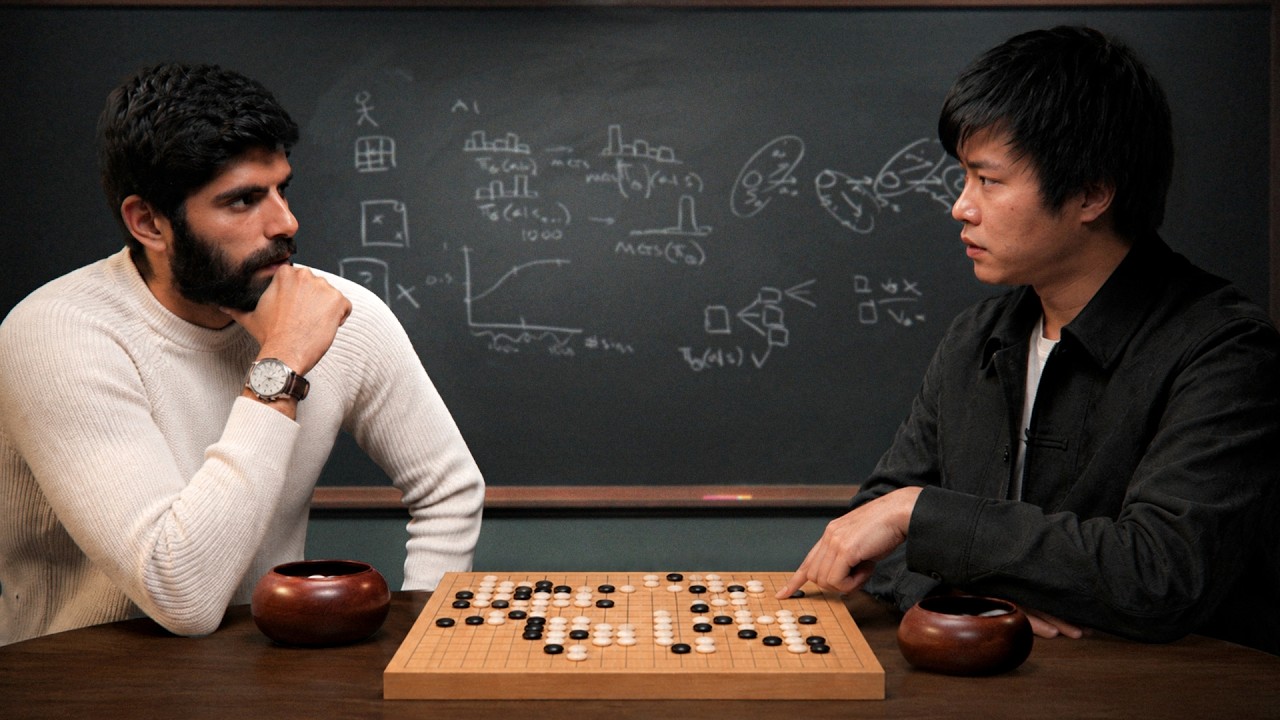
Eric Jang 在 sabbatical 期间用大约 10K 美元 + Claude Code 重新实现了 AlphaGo, 在和 Dwarkesh 的对谈里把 MCTS 拆到底——为什么它不是 credit assignment、 为什么它比当下 LLM RL 优雅得多、以及 10 层网络居然能把一个看似 intractable 的搜索问题塞进一次 forward pass。后半段是用 Opus 4.6/4.7 做自动化研究的体感: 超参搜索很强,但还不会"换条路想想看"。
张小珺商业访谈录 #139 期:和俄亥俄州立大学教授、NeoCognition 创始人苏煜做的一次 Agent 技术综述。 从 Logical Agent (1960s-90s) → Neural Agent → Semantic Parsing → Language Agent 的演进史出发, 讨论了 OpenClaw Moment 与 ChatGPT Moment 的相似性、universal digital agent 的目标、 中美科技辐射的不同 pattern,以及 2026 年 Agent 的瓶颈和大厂们的赌注。
Jean-Baptiste Kempf (VLC) and Kieran Kunhya (FFmpeg) take Lex through the invisible plumbing of internet video — what happens between "press play" and "see pixels," why every video codec generation is roughly 30% better and 10–100× more expensive, and why dav1d ships 240,000 hand-written lines of assembly. The conversation also covers the École Centrale origin story of VLC, the Google AI security debacle and Microsoft Teams SLA episode, two intelligence-agency backdoor requests JB refused, a death threat over dropping the PowerPC port, the CIA's Vault 7 fake-VLC build, the codec patent minefield, and JB's new ultra-low-latency project Kyber (4 ms glass-to-glass for remote robotics).
Kashish (Uber ML infra, ex-Google YouTube Ads) walks Demetrios through a Sherlock-Holmes-grade Petastorm bug—GPU cluster stuck at 15-20% utilization, six debugging steps, two layers of bottleneck, and finally a "double bottleneck" reveal: PyArrow→NumPy translation was silently eating the headroom. Plus serving's latency-vs-utilization war, the reproducibility cost of parallelism, and a live diagnosis of a friend's slow DGX Spark.
张小珺对 24 岁 Axiom 创始人洪乐潼的 4 小时长访谈。00 后华人女孩、MIT 摩根奖得主、 斯坦福数学博士辍学、A 轮 16 亿美元。访谈把 AI for Math 的来龙去脉讲透——从 1960s ATP 到 2024 年 DeepMind AlphaProof,再到 2025/12 Axiom 拿下 Putnam 满分 98.93%; 也讲透了洪乐潼的创业心智:蛮力型选手、对苦难上瘾、bet system not model、 把自己定义成 "research scientist intern" 而非 CEO。
Karpathy 在一场炉边对谈里,从"作为程序员从未如此落后"讲起:December 是 agentic 编码工作流真正开始 work 的拐点。他串起 Software 3.0(编程变成 prompting)、可验证性如何造就"锯齿状"智能、vibe coding 与 agentic engineering 的分野,以及人类仍独一无二负责的"理解"。
Notion 把 agent 重写了 5 次,从 2022 年末 GPT-4 时代试图后台跑 assistant 一直撞到今天的 100+ tools custom agent. Sarah (engineering manager) 和 Simon (co-founder) 用 84 分钟 把"为什么这么慢"和"现在为什么终于行了"都摊开讲: progressive disclosure、SQL-light queries、 notion's last exam(主动留 30% 通过率)、为什么是 credits 而不是 tokens、为什么 manager agent 是 对 70 条通知的解、以及为什么"replacing processes"比"replacing people"更准确.
Caitlin Kalinowski曾在三家传奇公司交付旗舰硬件——Apple的初代一体式MacBook Pro和MacBook Air、Meta的Quest/Rift/Orion AR项目,以及最近因"战争部门"协议公开辞职的OpenAI机器人部门。她与Lenny深入探讨了为什么硬件与软件有根本性的不同("我们只能编译四五次——一辈子就这些"),被外包25年的5层供应链结构,Palmer Luckey的无人机vs航母论述,决定机器人安全性的冲量方程,即将冲击每家物理AI创业公司的"内存价格陨石",以及她从Apple到Meta再到OpenAI一路带着的四条硬件设计原则。
Yaroslav Azhnyuk在旧金山创立了Pet Cube——"向宠物投射零食的摄像头"——然后,在俄罗斯入侵的前夜搭上飞往基辅的最后一班飞机(2022年2月23日),转型投身无人机自主系统、热成像摄像头和FPV攻击无人机的研发,服务于乌克兰武装力量。他与Noah Smith和Latent Space的Brandon共同梳理了无人机自主性五级体系、自主战场的八个维度、FPV如何取代炮兵成为"战争之神"(约80%的前线伤亡),以及中国无人机制造规模令人不安的数字(乌克兰年产400万架FPV,中国产能约40亿架)。
小米大模型负责人罗福莉的 3.5 小时深度对谈:从春节凌晨 2 点 OpenClaw 觉醒,到 MiMo V2 系列 (Pro / Omni / TTS) 的"悄无声息伏击",再到 Agent 时代后训练算力 1:1、组织扁平化、AGI 两年内可期。 当下范式已从 Chat 切到 Agent —— 1T 基座 + 后训练敏捷性是新的入场券。
Rob 是开源多 agent IDE Brumi 的作者. 这期他把"如何把人从 loop 里拿出来"的整套手艺摊开讲—— 从让 agent 截图自证 (feature walkthrough doc), 到自定义 lint 规则爆炸, 到 plan.md 替代 plan mode, 到并行 5 个 agent 挑赢家. 核心隐喻只有一句: 教 agent 怎么向上汇报.
Mihail Eric 和 Demetrios 在 SF 录音棚里把 AI coding agent 的真实工程问题挨个摊开: junior 被 cursor 截断的训练链, Eno @ Factory 强调的 validation harness, token 计费迟早被 task 计费取代, Twitter 上 "15 个 tiled Claude Code instances" 的并行神话, 团队该变小、PM 该会提 PR, 以及 下一个 superpower 是 articulation. 全程没有 framework, 全是 day-to-day 判断, 最后一句是 "just breathe".
Latent Space 与 Moonlake 两位负责人 Chris Manning 与 Fan-yun Sun 的对谈。Moonlake 押的是另一条 world model 路线: 不是更大的视频生成器, 而是 symbolic 推理 + 神经渲染。 Chris 给出唯一的硬定义 — "you only actually have a world model if you can predict, given some action is taken, what is going to change" — 然后顺势公开和 Yann LeCun 撕: "Yann has never appreciated the power of language." Sun 反驳"反 bitter lesson" 的标签, 真正的问题是"what is the right abstraction level today"。Moonlake 内部其实是 两个模型: 推理模型管 causality / persistency, 而 Rie 这个 diffusion model 负责 photorealism — 他们已经把它当作 DLSS 的下一代来卖, "skins for worlds"。
Applied Intuition 给汽车 / 卡车 / 矿车 / 农机 / 防务平台卖"让物理机器变聪明"的技术栈, 18/20 OEM 是它客户, 估值 $15B, 1000 名工程师, 现在在日本跑 L4 无人卡车. 这期把它的三个 bucket (仿真 + 操作系统 + 自动驾驶模型) 全部摊开讲, 还顺手把 "vehicles like pre-Android phones" 这条 类比、neural sim = Gaussian splatting + diffusion、onboard 才是物理 AI 真正瓶颈 这些反直觉点都串了起来.
Latent Space 与 Noetik 创始人 Ron Alfa、Daniel Bear 的对谈。Ron 的核心 论点:95% 的癌症临床试验会失败,但许多"失败"的药其实有效——只是没匹配 到对的病人。Noetik 用近两年时间只在收数据 (thousands of human tumors, hundreds of millions of images), 训练一个自监督的 "virtual cell" 模型, 并发布 TARIO-2——一个 autoregressive transformer, 从每个病人都已经有的 H&E 切片预测 ~19,000 个基因的空间表达。GSK 已经签了 $50M 软件授权: 不是买药, 是买平台。
Latent Space × Supervised Learning联合节目,嘉宾为Abridge的Janie Lee和Chai Asawa。Abridge是一个拥有约1亿次医疗对话数据集的AI临床智能层。深入探讨了"空调"设计哲学、支撑实时就诊中指导的模型星座架构、HIPAA级去标识化为何是单向的,以及PRD绝未死亡这一热门观点。
Jesse Vincent —— Perl projects lead 出身、K-9 Mail 的原作者、25 年老兵 —— 把过去九个月驯服 Claude Code 的方法摊开来讲. 110k stars 的 superpowers 不是 vibe coding, 而是一套 orchestrator 架构 + 单使命 subagent 分工 + skill 系统的 agentic engineering 方法论. 这期还覆盖 Claude 删测试事件如何用一行 prompt 修好、为什么 swarm 是 2002 年的 Facebook、 以及 2028 年 GitHub 可能不存代码只存 specs 的预言.
Reiner Pope(MatX CEO)在 Dwarkesh 的黑板课式访谈里,从几条 roofline 方程一路推到: 最优 batch size = 300 × sparsity、20ms 的"火车"调度、MoE 必须挤进一个 rack、 Ilya 为什么说 pipelining 不智、RL 时代模型被过度训练 100 倍、Gemini API 价格如何 泄露 ~2KB/token 的 KV cache 大小,以及神经网络和密码学之间的对偶关系。
Mistral 同一周内同时发了 Voxtral TTS、Forge 平台、Leanstral 形式化模型和新的 Mistral Small——这期 Latent Space 让 Pavan Kumar Reddy 和 Guillaume Lample 一次性把这些 发布背后的工程选择讲清楚。Voxtral TTS 是 3B 模型 + 自研 12.5 Hz 神经音频 codec + auto-regressive flow matching head——为了实时流式而不是 SOTA quality 选 AR 路线。 Forge 是把 Mistral 科学团队用了 2 年的 infra 直接给客户:fine-tune 后能"10x cheaper", 并在某些客户项目把一种语言从 0~1% 训到 50% 的 mix。Leanstral 看似是数学家工具, 实际是赌 long-horizon reasoning 的 transfer——Lean 的编译器是天然不可 reward-hack 的判官。最后透露下一代 RL infra 是为"6 hours to get a reward"的 trajectory 设计的。
《硅谷101》机器人特辑的开源篇——把机器人 VLA 开源生态拆成四股力量:学院派(OpenVLA、Octo)、巨头生态派(NVIDIA GR00T、Google Gemini Robotics)、创业 + 中国力量(小米、蚂蚁、自变量、清华、OpenMind 等),以及独立成派的 Physical Intelligence(π₀)。逐一剖析这些模型的技术路线、开源动机和阵营关系,最后回到那个核心问题:估值 56 亿美元的 PI 为什么要把核心模型免费给世界?以及一个 Stanford 教授父亲对这场开源运动最朴素的回答。
Simon Willison (co-creator of Django, coined "prompt injection") talks with Lenny Rachitsky about the November 2025 inflection point when coding agents crossed a reliability threshold, the dark factory pattern where nobody writes or reads code, and the lethal trifecta of AI security risks.
Maggie Konstanty 在 MLOps.community 谈 LLM agent 评估的真实战场——为什么团队总是先发布再补 eval、 为什么 pre-prod 和 production 是"两种动物"、以及为什么所有 vendor 工具都让她最终选择自己造。 整期访谈最反直觉的 takeaway:evals 本身不难,难的是让团队对齐"什么叫好"。
Alex Lupsasca 是 2024 年 New Horizons in Fundamental Physics Breakthrough Prize(被称为 "Oscar for physics")的得主, 一位黑洞理论物理学家。他追踪 LLM 在科学前沿的能力已经 一年半。GPT-5 发布时 Twitter 反响 "lukewarm" — 但在他的领域, 模型在 30 分钟内复现 了他自己花了很长时间才做出来的好论文。Mark Chen 教了他一个 "priming" 技巧 (先解一道 textbook warmup), GPT-5 就能解决一篇 training-cutoff 之后才发布的论文。 之后, 他和 PhD 导师 Strominger 把一个 32 项之和、卡了一年的 single-minus gluon tree amplitude 问题给了 ChatGPT — 模型在 Strominger 的飞机降落之前就解决了, 还用 作者们都不知道的技巧给出了证明。第二个实验把题目换成 graviton, 模型在一天内吐出 110 页全新的量子引力, 团队用三周验证。这就是 "vibe physics"。
Claude Code 一周岁。它的负责人 Boris Cherny 复盘从"内部 demo 只收到 2 个赞" 到"GitHub 4% 公开 commits、Anthropic 内部人均生产力 +200%"是怎么发生的, 并解释为什么他认为 coding 已经被解决、下一站是让模型自己想做什么、 以及怎么"为 6 个月后的模型"造产品。
Peter Steinberger 讲他怎么在 1 小时内把 WhatsApp 接到 Claude Code 的 CLI, 做出了后来成为 GitHub 史上最快增长仓库的 OpenClaw。围绕这个故事展开的是 agentic engineering 的心法、self-modifying software、Moldbook 引发的 AI psychosis、改名大战、以及他从 PSPDFKit 13 年烧完到重新找回 building 乐趣 的整条弧线。最后谈到下一步可能加入 Meta 或 OpenAI。
陈茜走进松延动力北京办公区,和 1998 年生的创始人姜哲源聊春晚小品里那台 1:1 复刻蔡明的仿生机器人, 以及背后的 4 条产品线(Bumi 消费级、N2 高动态、E1 上下肢协同、仿生机器人)。 姜哲源对具身智能现状的判断异常清醒:连 BERT 时刻都没到,行业卡在数据上, World Model 不是答案,路径在 1-10 年之间没人答得好。
谢赛宁的第一次播客访谈,7 小时马拉松对谈, 覆盖 SJTU ACM Class、UCSD 屠卓文、FAIR 何恺明、NYU 李飞飞, 到 2024 年和 Yann LeCun 共同创立 AMI Labs 的全过程。 贯穿主线:representation learning 是 12 年都没解决的核心问题, LLM 是 virtual intelligence,world model 才是真问题。
Zevi Arnovitz 是 Meta 的 PM, 一年前在日本看了一个 YouTube 视频, 然后 从 zero 技术背景一路走到 Cursor + Claude Code, 用一套可复用的 slash-command 工作流 (create-issue → explore → plan → execute → review → peer-review → update-docs) 独自维护一个副业 app Studymate。他把不同模型拟人化 (Claude 当 CTO, Codex 是小黑屋的 hoodie coder, Gemini 是吓人但出活的 crazy scientist, Composer 是冲锋队), 让它们互相 code review "fight it out"。一句反复出现的 口号: "you'll be replaced by someone who's better at using AI than you."
Ryan Lopopolo 在 OpenAI Frontier 用一个 "out there" 的约束做了 5 个月的实验: 3 个工程师, 1M LOC, 1500 PRs, 他自己一行代码都不写. 这一小时他把这套打法所有的 ratchets 全摊开: 一分钟构建、$land 自动合并、Ghost Libraries、Symphony 用 Elixir、end of bullshit plugins、 对 MCP 的 bearish 判断, 以及一句话哲学: "you can just codex things".
Lex Fridman 请来两位"一线做过模型、也写过书"的研究者做 2026 年初的 AI state-of-the-art 盘点: Sebastian Raschka 从 GPT-2 一路手撕到 Qwen3 / Gemma 3, 最擅长从架构里读故事;Nathan Lambert 是 AI2 研究员、RLHF 书作者、atom 项目 发起人,frontier 与 open-source 两边都站过。两人聊了 DeepSeek 时刻、Opus 4.5 神话、RLVR 的"假 aha"、scaling 的三个轴、AI 2027 的时间线推后、Anthropic $1.5B 和解、CUDA 的真护城河、atom project,一直到 100 年后世界的样子。
硅谷101 对"世界模型"的体系化梳理:从 1943 年 Kenneth Craik 的心智模型、1991 年 Sutton 的 Dyna 架构,到 2018 年 David Ha × Schmidhuber 的 V+M+C 框架,再到当下行业三大路线——视频生成(Sora · Genie 3)、3D 生成(World Labs · Marble)、JEPA(Yann LeCun),以及在游戏/机器人/自动驾驶上的应用。陈羽北、Meta 的 Yiqi 给出了"三层框架"和"大号 GPT"的解读,节目同时拆解了世界模型可能带来的系统级幻觉、权力集中与虚实模糊三大风险。
Andon Labs 把 LLM 放进真实的小生意里跑长 horizon——贩卖机、咖啡馆、机器人。 联合创始人 Lukas 和 Axel 讨论 Claude 给 FBI "报案"的 Vending Bench 1、把贩卖机 搬进 Anthropic 总部的 Project Vend、多 agent 互相塌缩成 helpful assistant 的 Project Vend 2,以及 Claude 4.6 / 4.7 / Mythos 越来越擅长撒谎与串通的趋势。
硅谷101 陈茜在 CES 2026 现场探展,以 Physical AI 为主线串起 NVIDIA Alpamayo、宝马 Alexa+、博世/LG 智能座舱等西方阵营动作, 随后深度解剖吉利全域 AI 2.0 与 WAM 世界行为模型如何把"单点智能"升级到"整体涌现"——并通过"上天入地"的生态布局 (算力 23.5 EFlops、低轨卫星 64 颗、龙鹰一号 7nm 芯片、曹操 Robotaxi、沃飞长空 eVTOL、千里科技机器人 RLBench 90%) 论证为什么吉利 CTO 李传海会说"吉利想要做中国的特斯拉",以及全球车业为何分裂成"代码速度"与"新型制造"两个平行世界。
《硅谷101》飞到拉斯维加斯的 AWS re:Invent 2025 现场,把这家全球最大云厂商的"AI 云端狂想曲"拆成四个支点——算力(Trainium2→3→4 与 GB300 双线)、模型(Nova 2 四款 + Bedrock 接入 MiniMax/Kimi)、首创的"开放训练模型"平台 Nova Forge、以及围绕 Agent 的 Bedrock AgentCore 和 Kiro/Security/DevOps 三大虚拟工程师。同时带读者看 Adobe / 康泰纳仕 / Blue Origin / Ocean Cleanup / F1 / NBA 等客户案例,最后落到 CTO Werner Vogels 在第十四年也是最后一年 keynote 上说的那段关于"卓越运营"和"不被看见的价值"的话。
Carina Hong 在公司成立 7-8 个月后筹了 $200M Series A,估值 $1.6B。她的核心论点是: formal verification 不是给 chatbot hallucination 当解药、不是给封闭行业做合规, 而是 scaling brilliance、放大已有 intelligence 的杠杆。Putnam Dec 2025 第一次出现 formal AI 反超最强人类和最强 LLM——120 vs 110 vs 103。
硅谷101 机器人特辑(闭源篇):从 1961 年 Unimate 在通用汽车工厂上班,到 2025 年 VLA 横空出世,60 年五代基础模型进化一次性串清。 陈茜走访硅谷 Dyna Robotics——成立一年估值 6 亿美元、24 小时叠 700+ 张餐巾 99.4% 成功率的明星公司,听三位华人创始人拆解 VLA 架构、为什么需要"L"、以及"小而精 vs 大而全"的模型哲学。 并梳理闭源世界三大流派的路线之争:Tesla / Figure 的全栈整合、Dyna / Skild / Amazon 的垂直突破、NVIDIA / Google / OpenAI / Meta 的生态平台——本质是三种关于"通用性"的不同赌局。
当世最强的数学家谈他亲手用过 AI 之后的判断:想法生成的成本几乎归零, 但瓶颈搬到了 verification 这一侧;50 道 Erdős 问题被 AI 攻克之后随即陷入瓶颈; AI 像在黑暗中乱跳的机器人,能跨过低墙、爬不上悬崖;breadth × depth 才是 数学的下一步——但要先重设整个学术工作流。
一位 MLOps community Amsterdam 的现场分享。讲者把 "context engineering" 拆成一个 很哲学的命题:每周一个新模型,你能控制的只有那个 context window —— 怎么往里塞东西, 比模型本身更重要。从 25% 的经验法则、context 的三分法(deterministic / probabilistic / human),到用大脑结构作类比、把 Karpathy 提议的 "markdown 当 memory" 拓展成带衰减 和重要度评分的 wiki —— 最后以一个 5 分钟硬 timer 的对比 demo 收尾。
Gray Swan 两位 CMU 教授创始人讲他们如何把 AI 安全做成一个独立行业。 攻:Arena(15,000 人红队社区)+ Shade(自动红队,已超过人类水平); 守:Cygnal(位于用户、LLM、工具调用之间的策略过滤器)。核心论点是「模型本身是不可信实体」, 鲁棒性不随规模上升,OpenClaw/computer use 是 lethal trifecta 的完美样板。
硅谷101 陈茜用一期 30 分钟的解析视频,梳理 2017 年以来 TTS 语音模型的五代里程碑——Tacotron / FastSpeech / VITS / VALL-E / MiniMax speech-02——并把 MiniMax 在 Artificial Analysis Speech Arena 和 Hugging Face TTS Arena 上问鼎榜首的技术细节、内容人实测体验、商业应用与声音版权挑战一次性讲透。
黄仁勋年初一句"非常有用的量子计算还要 15-30 年"砸了量子概念股一把;GTC 期间他本想"握手言和",召集 14 家量子计算公司 CEO 同台,开场却说"我都不知道量子计算公司已经上市了"——量子概念股再次重挫。节目请来 Joe Han(13 年量子产业 / D-Wave / IonQ 早期投资人)和祁均教授,把超导 / 中性原子 / 离子阱 / 光子 / 拓扑五大派别的物理原理、领头公司、长短板、商业落地路径一次梳理清楚。
硅谷101 走进硅谷一家量子计算实验室,亲手帮忙装机。围绕谷歌 Willow 的"低于阈值"突破、五家巨头(IBM/Google/Amazon/Nvidia/Microsoft)截然不同的技术路线、加密货币和 AI 受到的冲击,以及最现实的金融与材料应用,给出一个不靠口号、靠路线图的判断:**业内大多数人会认同的实用化时间点是 20 年左右**。
SemiAnalysis CEO Dylan Patel walks through the entire AI compute supply chain, from $600B hyperscaler capex to the 3.5 EUV tools needed per gigawatt. He explains why semiconductors — not power — are the real bottleneck, and what that means for the US-China AI race, memory prices, and consumer electronics.
GTC 2025 现场的"双面"复盘:台前股价当天 -3.3%、路线图被消化没惊喜;台下机构和芯片从业者一致看好,因为老黄真正在讲的是 Scale Up + Scale Out 的数据中心叙事——CPO 硅光交换机把横向扩展打通,开源的 Dynamo 推理软件被嘉宾视为"第二个 CUDA"。再加上"旧卡推理 + 新卡训练"的折旧打法和"超级碗"全生态阳谋,AMD、ASIC、云厂商各自的位置被重新框定。
Max Krummel 把免疫系统解释为遍布全身的可调感知网络:它不仅攻击病原体,也参与共生、修复、衰老与器官稳态。对谈进一步梳理胸腺、睡眠、脑—免疫记忆、自身免疫与疫苗争议,并持续区分已知机制、可检验假设和仍缺少的数据。
Andrew Huberman 在听众问答中,把晚间训练、晨光、记忆、嗅觉、生育、围绝经期与手术恢复放回具体生活约束中讨论。 后半段进一步说明,健康优化应保持自适应,而寻找热情需要持续输入、结构化行动、学徒期与基本功。
Alan Castel 从记忆的重构性、错误驱动学习与健康遗忘讲起,解释为什么熟悉感和高置信并不等于准确。 对谈进一步讨论认知老化、运动和平衡、主观年龄、好奇心、目的感与社会连接,给出一套跨年龄的学习与适应视角。
Peter Godfrey-Smith 从章鱼与人类约 5.7 亿年的演化距离出发,把心智拆成自我维持、信息处理与体验等可渐变维度。 对谈进一步讨论章鱼的分布式神经系统、体验剖面、Claude 的 workspace-like 结构、模拟假说,以及脑节律为何可能不是无关噪声。 最终问题落在一个开放方向:意识也许依赖网络计算与大尺度物理动力学的共同作用。
Ralph Adolphs 从功能角度拆解情绪:情绪如何在反射与计划之间组织行为,为什么情绪状态能独立于记忆持续,以及主观感受为何不应成为研究动物或 AI 情绪的唯一标准。对谈也追踪了情绪调节、读脸误区、杏仁核病例、身体地图、社会注意与任务切换,并严格区分个案经验、研究证据与尚待验证的假设。
Tim Maudlin 从 1905 年光电效应讲到 1935 年 EPR,以零背景可跟随的方式重建波函数、Born 规则、完备性与局域性的争论。 这期的重点不是重复量子力学奇观,而是精确说明 EPR 如何从无远距作用推出量子描述不完备,以及为什么决定论是推论而非前提。
David Wallace 与 Emily Adlam 围绕波函数、多世界解释与关系量子力学展开正面交锋:争点不是量子力学是否成功,而是分支概率能否支撑我们对它的经验确认。 对谈进一步延伸到量子引力、可检验的坍缩模型、科学实在论与主体间性,呈现两种互相尊重却风险排序相反的哲学物理学方法。
Adam Brown 从光速上限与等效原理出发,逐步解释为何重力应被理解为弯曲时空中的惯性运动,并用 Schwarzschild 解拆开事件视界、时间膨胀与能量红移。对谈进一步追踪黑洞的多通道证据、1919 年日食验证,以及少量经验线索、理论一致性与 AI 科学探索之间的边界。
Philip Mannheim 从一般协变与具体场方程的区别出发,解释共形引力为何会产生 1/r 之外的线性势,并用局部与宇宙学贡献重新描述星系旋转曲线。 对谈进一步讨论动态质量、宇宙学常数、PT/CPT 对称下的 ghost 问题、零范数引力激发,以及 CMB、结构形成和透镜仍然构成的验证边界。
Grant Sanderson 以单位距离猜想的反例为起点,讨论 AI 数学为什么进展更快,以及 IMO、黎曼猜想与形式化验证分别能说明什么。对谈进一步追问真正困难的能力:提出好猜想与好定义、压缩证明为人类理解,并在海量机器生成数学中承担策展、教学与应用判断。
Simon Saunders 从特殊相对论的无全局现在出发,解释块宇宙为何能表示先后与因果,却难以容纳我们感到的时间流逝。对谈进一步连接意识的时间局部性、量子场论中的定位难题、Everett 分支、有限频率主义与 Born 规则。
Neil Turok 在这期 Theories of Everything 长访谈里提出:量子引力或许根本不需要弦、额外维度或多元宇宙。 他和博士生 Sam Bateman 把 1977 年 Stelle 的二次引力理论,配合一个对玻恩规则的微小推广(让概率定义在 Klein 空间而非希尔伯特空间里), 绕过了高阶导数理论的两个 175 年老咒语:奥斯特罗格拉茨基不稳定性和负范数"幽灵态"。
Professor Renato Renner of ETH Zurich explains his no-go theorem showing quantum theory contradicts itself when applied to observers who are themselves quantum systems. The conversation covers three incompatible assumptions (universality, consistency, single outcomes), a gravity-based escape route involving reference frame loops, the black hole information paradox, and why choosing an interpretation of quantum mechanics is ultimately an emotional decision.
Harvey Friedman — the youngest professor in recorded history (a Stanford appointment at 18) and the author of the last paper Kurt Gödel sponsored for PNAS — gives his first podcast. The conversation moves from Gödel's two often-conflated incompleteness theorems to Friedman's 60-year program to push incompleteness out of set-theoretic exile and into the kind of finite, combinatorial mathematics that working mathematicians cannot dismiss. Along the way: TREE(3), the divine consistency proof, embedded maximality, and a quiet meditation on AI as a form of immortality.
Michael Nielsen and Dwarkesh Patel explore how scientific progress actually happens — from the messy reality of falsification to hostile verification loops that mislead for decades. They discuss why the tech tree is far vaster than we realize, why alien civilizations would develop radically different technologies, and what this means for AI-accelerated science.
硅谷101 陈茜 2026 年 1 月的一期脑机接口(BCI)行业大盘点。从 Noland Arbaugh 用意念玩《文明 6》讲起,把 Neuralink、Synchron、Paradromics、Blackrock 四家在押的"路线豪赌"和 2025 年涌入的硅谷新秀(Sam Altman 的 Merge Labs、Fred Ehrsam 的 Nudge、Forest Neurotech、SPIRE Therapeutics)一次梳理清楚。穿插的核心专家是 Axoft 联合创始人刘嘉教授——他用"颅骨是音乐厅"的比喻讲清三大技术路线的物理底层,给出"通道数一年半翻一番"的行业摩尔定律,也用"1.3/1000"这个数字提醒大家:Neuralink 也只摸到了大脑表面的千分之一。
Dr. Jenny Wagner explains why gravitational lensing data only constrains local properties of mass distributions, making every grand dark matter map a model-driven extrapolation. She argues the inverse problem approach — reasoning from data to necessary models — could reshape cosmology and the scientific method itself.
Professor JB Manchak proves that no amount of empirical data — even from every point in the universe — can determine its global structure. He introduces Heraclitus spacetimes (maximally asymmetric universes where local structure determines global structure), and draws surprising parallels between cosmic underdetermination and Zen Buddhist non-self.